بیوانفورماتیک ساختاری و Homology modeling
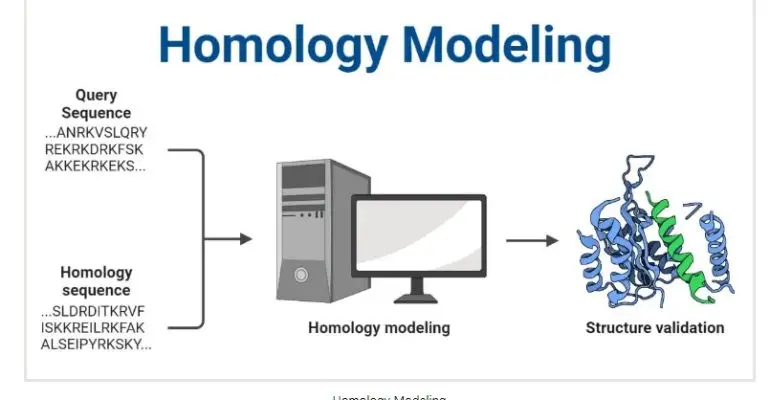

هدف از مدلسازی پروتئین، پیشبینی ساختار با استفاده از توالی و با دقتی است که با بهترین نتایج به دست آمده تجربی قابل مقایسه باشد. این امر به کاربران این امکان را میدهد تا براساس یافته ها به اهدافی همچون طراحی دارو براساس ساختار، تجزیه و تحلیل عملکرد پروتئین، برهمکنشها، رفتار آنتی ژنی و طراحی پروتئینها به منظور افزایش پایداری آن ها دست یابند. از سویی دیگر مدل سازی پروتئین تنها راه برای به دست آوردن اطلاعات ساختاری در صورت ناموفق بودن تکنیک های دیگر آزمایشگاهی است. بسیاری از پروتئین ها برای آنالیز NMR بسیار بزرگ هستند و نمی توانند برای X-ray diffraction کریستاله شوند.
به طور کلی در میان رویکرد های اصلی پیشبینی ساختار سهبعدی، homology modeling «آسانترین» روش محسوب می شود. این روش بر این واقعیت متکی است که ساختار سه بعدی پروتئین ها اغلب بیشتر از توالی اسید آمینه آنها حفاظت شده است. بنابراین، پروتئین هایی با توالی های مشابه احتمالاً ساختارهای مشابهی دارند.
در عمل، homology modeling یک فرآیند چند مرحلهای است که مراحل آن به شرح زیر خلاصه شده است:
۱. تشخیص الگو و alignment اولیه
۲. تصحیح alignment
۳. نسل اصلی(Backbone generation) یا ساخت مدل سه بعدی
۴. مدل سازی حلقه(Loop modeling)
۵. مدل سازی زنجیره جانبی(Side chain modeling)
۶. بهینه سازی مدل
۷. اعتبارسنجی مدل
۸. تکرار
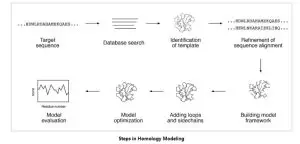
همانطور که اشاره شد homology modeling یکی از روش های پیش بینی ساختار محاسباتی است که برای تعیین ساختار سه بعدی پروتئین از توالی اسید آمینه آن استفاده می کند. این روش دقیق ترین روش پیش بینی ساختار محاسباتی در نظر گرفته می شود.
مرحله ۱. تشخیص الگو و alignment اولیه:
اولین گام در این فرآیند، شناسایی و انتخاب ساختارهای الگوی مناسب از بانک داده پروتئین (PDB) است.
برای شناسایی الگوهای مناسب، میتوان از روشهای alignment توالی جفتی(pair-wise sequence) مانند BLAST برای شناسایی پروتئینهایی با همسانی توالی بالا با پروتئین مورد مطالعه در PDB استفاده کرد.
روشهای حساستر شامل انجام alignment توالی چندگانه(multiple sequence) یا استفاده از روشهای تکرارشونده خودکار مانند PSI-BLAST است.
اگر همسانی بین پروتئین مورد نظر و الگوها کم باشد (زیر ۳۵%)، روشهای جایگزین مانند alignment پروفایل-پروفایل، و Hidden Markov Models (HMMs) برای کاهش شکافها در alignment استفاده میشوند.
پس از شناسایی چندین الگو، مناسب ترین آنها برای مدل سازی باید انتخاب شوند. عواملی مانند هویت و شباهت توالی، امتیازهای alignment، روابط فیلوژنتیکی و همچنین اطلاعات دیگری مانند عملکرد بیولوژیکی و زمینه محیطی باید در نظر گرفته شوند.
مرحله ۲. تصحیح alignment :
در homology modeling، همسویی توالی query با الگو گام مهمی در انجام این فرآیند است.
دستیابی به یک توالی alignment با کیفیت بالا ضروری است زیرا به طور مستقیم بر دقت مدل حاصل تأثیر می گذارد. اصولا alignment چند توالی ترجیح داده می شود زیرا حاوی اطلاعات تکاملی است که برای ساختار و عملکرد مهم هستند. برای این منظور برنامه های alignment مانند Proline و T-Coffee توصیه می شود.
با این حال، حتی بهترین برنامه، ممکن است حاوی خطا باشد، بنابراین لازم است کاربر این برنامه ها alignment را بررسی کند تا مشخص شود که رزیدوهای حفاظت شده به درستی تراز شده اند.
مرحله ۳. ساخت مدل سه بعدی:
alignment توالی توسط ساخت مدل سه بعدی پروتئین های هدف دنبال می شود. روش های مختلفی برای تولید مدل های سه بعدی پروتئین بر اساس الگوهای آن استفاده می شود. MODELLER یک بسته نرم افزاری است که معمولا برای انجام این روش استفاده می شود.
مرحله ۴. Loop modeling:
هنگام مدلسازی پروتئینها اغلب شکافهایی وجود دارند که میتوانند در alignmentهای توالی ایجاد شوند. این شکاف ها، حلقه(Loop) نامیده می شوند و از نظر ساختاری در طول تکامل کمتر حفاظت شده اند.
مدلسازی حلقه یک مرحله مهم در پیشبینی ساختار پروتئین است زیرا حلقهها نقش مهمی در تعیین عملکرد پروتئین دارند. با این حال، پیش بینی ساختار آنها یک فرآیند پیچیده است.
مرحله ۵. Side chain modeling:
مدلسازی زنجیره جانبی فرآیند پیشبینی ترکیب زنجیرههای جانبی اسیدهای آمینه در ساختار پروتئین است. این فرآیند در ارزیابی برهمکنش های پروتئین-لیگاند و پروتئین-پروتئین بسیار مهم است.
این فرآیند معمولاً با قرار دادن زنجیرههای جانبی بر روی بدنه اصلی(backbone) که از ساختار مادر یا شبیهسازیهای اولیه مدل سازی مشتق شدهاند، انجام میشود.
مرحله ۶. بهینه سازی مدل:
مرحله بعدی بهینه سازی مدل است. بهینه سازی یک مدل، به فرآیند اصلاح مدل اولیه برای افزایش دقت و قابل اطمینان شدن آن اشاره دارد.
این فرآیند بهینهسازی شامل تنظیم موقعیت اتمها در مدل برای کاهش هرگونه برخورد یا موانع فضایی بین اتمها است. فرآیند کمینه سازی انرژی(energy minimization) یکی از روش های بهینه سازی مدل است.
مرحله ۷. اعتبارسنجی مدل:
پس از ساخت مدل سه بعدی پروتئین query، اعتبارسنجی و ارزیابی کیفیت آن ضروری است تا اطمینان حاصل شود که مدل بدست آمده از نظر بیولوژیکی مطابقت دارد و می تواند برای مطالعات بیشتر مورد استفاده قرار گیرد.
homology modeling کاربردهای عملی زیادی دارد:
- homology modeling برای پیشبینی ساختار پروتئین هایی که مدل سازی آنها با استفاده از تکنیکهایی مانند کریستالوگرافی اشعه ایکس یا NMR دشوار است، اهمیت دارد.
- homology modeling برای پیش بینی خواص عملکردی پروتئین هایی با ساختار ناشناخته با مدل سازی ساختار پروتئین و مقایسه آن با ساختارهای شناخته شده پروتئین های مرتبط استفاده می شود.
- homology modeling همچنین در مطالعه تکامل خانوادههای پروتئینی با مقایسه ساختار پروتئینهای مرتبط از گونههای مختلف برای شناسایی تغییراتی که در طول تکامل رخ داده است، مفید است.
- homology modeling میتواند برای شناسایی اهداف دارویی با پیشبینی ساختار پروتئین برای درک عملکرد آن و شناسایی مکانهایی برای اتصال دارو مورد استفاده قرار گیرد. از این اطلاعات می توان برای طراحی داروهای جدید یا بهینه سازی داروهای موجود استفاده کرد.